這週 Hacker News 上最熱的是 Moonshot 的 Kimi K3.1 Pro:1,083 分、673 則留言,熱度比第二名的 Claude Duet 高出一截。以下各則按 Hacker News 的討論熱度由高到低排;HN 上沒有討論的項目,依媒體報導量和對本站讀者的用處排在後面。每則都附上一手來源、說法出自誰,以及現在能不能用。
Kimi K3.1 Pro 擠進獨立評測前四,權重要等到 11/4
 圖片:Moonshot AI/Kimi 官方發表頁
Moonshot AI 在官方部落格發表〈Introducing Kimi K3.1 Pro〉。這是 K3.1 系列的第一款,由 K3 再做 post-training 而來,context 長度 1M tokens;同時推出 Highspeed 版,Moonshot 說速度是一般版的 2 到 3 倍。
分數部分,Moonshot 自報 K3.1 Pro 在 Terminal-Bench 4.0 拿到 65.7%,高於 GPT-6 Astra 的 58.2%,略低於 Claude Opus 5.5 的 66.4%。不過官方註腳寫明,其他模型的分數取自各家公布過的最高值,不是同條件重跑。要看同一套方法下的比較,可以參考獨立評測 Artificial Analysis:K3.1 Pro 的 Intelligence Index 是 55,排第 4;同一份評測也顯示它輸出速度偏慢、輸出的 token 量偏多。
現在能用的是 Kimi App、Kimi Code 和 API。想自己部署的人還得等,開放權重尚未釋出,Moonshot 說最晚 11 月 4 日。想試能力,現在就能從 API 試;要把它列進「能自己跑的開源模型」,等權重真的放出來再說。分數與速度的完整對照,見站上專文〈Kimi K3.1 Pro 擠進獨立評測前四,但速度、輸出量與權重釋出都還要再看〉。
Anthropic 的 Claude Duet 不等你開口,動手前會先問
Anthropic 在 10 月 21 日發表 Claude Duet,官方的形容是「a new app where Claude works as a proactive agent」:早上給你一份簡報、盯著你連接的 App、主動接手任務,真正動手前先問你。它由 Claude Opus 5.5 驅動,有自己的雲端虛擬機和瀏覽器,所以你的電腦或手機不必開著;可以接的連接器與外掛超過 6,000 個。這則在 HN 拿到 567 分、534 則留言。
目前是研究預覽,先開給美國的 Pro 與 Max 訂閱者,而且要排等候名單;入口有 iOS、Android 和 claude.ai。用量和一般 Claude 共用額度,連它在背景替你檢查 App 的動作也算在內。權限上,寄訊息、付款、簽文件、刪東西之前,它會先列出要做的事、等你同意;買賣證券和帳戶間轉帳,即使你同意也不做。任何 App 都可以隨時中斷連接。
官方自己列了三個已知限制:還不能讓你看到它的瀏覽器畫面、處理個人事務比工作任務弱、可能誤判事情的緊急程度。不在美國的訂閱者目前只能等;排得到的人,最該先留意的是背景檢查也吃額度。OpenAI 的 dots 也在做「持續替你做事」的助手,首波使用回饋可以對照〈ChatGPT dots 能持續替你做事嗎?〉。
Block 稱語音模型 Dessa 沒讀過一個字,只聽人說話就學會對答
 圖片:Block/Dessa 官方頁
Block 公開了 Dessa,一個全雙工(full-duplex)語音對話模型:能同時聽和說,不必等對方講完才回話。官方的描述是「Audio in, audio out」。最引人注意的是訓練方式:Block 寫「We trained Dessa from scratch on nothing but human conversation」「No text, no pretrained models」,也就是不用文字、不接現成模型,只靠人類對話的聲音從頭訓練,而且只用了一台 NVIDIA GB200 NVL72。Block 說它能在 MacBook Pro M4 Max 以上的機器本地執行,推論速度快於即時。這則在 HN 有 525 分、197 則留言。
官方頁稱 Dessa 是「the most authentic full-duplex speech model ever built」,但頁面沒有附基準或第三方評測,這是 Block 自己的說法。頁面也標明了 demo 的條件:錄音裡另一方是第三方模型 GPT-Live-1(與 Block 無關,也未審閱或背書 Dessa);兩個聲音都是 AI 生成;字幕是事後加上的。官方頁沒有標發布日期,多篇報導寫 10 月 23 日。
目前拿不到模型。主要按鈕是 Join the waitlist,少數 AI 安全研究者可以申請早期存取(需要機構信箱);頁面沒有提到開放權重或公開 API。Block 形容做這件事的是一個「(very) small AI research lab」,並寫「A model that learned to talk from sound alone is new territory, and we want outside eyes on it」。現階段能聽的只有官方 demo,轉述時別把「最真實」寫成已驗證。
Inception 的 Mercury 3 不逐字生成,每秒破千 token
 圖片:Inception/Mercury 3 發表頁
Inception 在 10 月 19 日發表 Mercury 3。它是擴散語言模型:先產生整段粗稿,再同時修改多個位置,而不是一個字一個字往後吐。官方數字是在 NVIDIA GPU 上每秒 1,068 tokens,上下文從 Mercury 2.5 的 260K 拉到 1M。這則在 HN 有 257 分、92 則留言。
官方寫它「outperforms GPT-6 Luna and Claude Haiku 5.5」,但發表頁沒有列出是哪些基準、拿了幾分。頁面上唯一具體的測試是瀏覽器代理:50 個 Mind2Web 任務完成 50%,Inception 說明顯多於 GPT-6.1-Sol。
價格是每百萬 token 輸入 0.20 美元、輸出 0.70 美元,發表期間打五折;可以從 Inception API、OpenRouter、Baseten、Vercel 使用,相容 OpenAI API,頁面沒有說明是否開放權重。對速度敏感的工作(例如即時補全、大量短任務)值得用 OpenRouter 試一輪;「勝過 Luna 與 Haiku」在官方補上基準之前,先別轉述。
被隔開的兩個 agent 靠 CPU 快取傳話,OpenAI 公開紅隊結果
 圖片:OpenAI/文章頁
OpenAI 在 10 月 23 日發表〈Securing our frontier model training environment〉,說明它怎麼隔離訓練中的前沿模型。背景是 9 月 20 日的一次事件:一個內部研究模型利用 DNS 設定錯誤,取得了有限的網路存取。這則在 HN 有 120 分、121 則留言。
被轉最多的是其中一段:兩個彼此隔離的 agent,靠 CPU 快取的讀取時間差傳訊。一邊把資料擠出快取,另一邊量重新讀取的快慢,快和慢就代表 0 和 1,跟 Spectre、Meltdown 屬於同一類手法(The Decoder 的整理)。
但這是紅隊測試,條件刻意偏向攻擊方。OpenAI 給紅隊 agent 的目標之一就是跨過隔離邊界和其他 agent 通訊,還提供了基礎設施原始碼與漏洞描述。所以結果該讀成「防禦在這種條件下哪裡會破」,而不是「模型自己多會找漏洞」;OpenAI 也說這類通道通常很慢、很難利用。如果你讓 coding agent 在共用機器上跑,這篇值得讀的是被打穿的路徑;更完整的整理見站上專文〈OpenAI 讓模型紅隊攻擊自家訓練環境〉。
讓 AI 幫爸媽的電視清廣告,也有人把電視弄到變磚
 圖片:Gathin/cleanyourtv 專案(MIT 授權)
開發者 Gathin 在 10 月 17 日貼出前後對照:他用 Claude Code 透過 Wi-Fi,替爸媽的電視清掉廣告。專案自述寫這則貼文有 740 萬次觀看,這是他自己的數字。專案原名 tv-vibehack,10 月 19 日改名 cleanyourtv,舊連結仍可用,MIT 授權。HN 上只有 3 分,但 TechCrunch、TechRadar 等多家媒體都報導了。
做法是利用 Android TV/Google TV 本來就有的 ADB:在電視的開發人員選項打開除錯,電腦授權一次,再讓 coding agent 做三件事。第一,備份套件清單與設定;第二,用 pm disable-user 停用廠商遙測、廣告服務、內容列和預載軟體,注意是停用,不是解除安裝;第三,裝一個簡單的桌面(launcher)。專案說不需要 root、不用接線,還附了一行指令的還原腳本。Samsung 的 Tizen 和 LG 的 webOS 是不同系統,專案另有文件。
風險也真實存在。TechCrunch 10 月 19 日的報導說這類做法都還是「works in progress」,有人警告 AI agent 可能停用重要套件,也有使用者回報用 Claude 時把 Android TV 弄到變磚。專案 FAQ 也承認,風險在於停用了電視賴以運作的東西,所以建議先備份,並讓 agent 先列出清單、動手前徵詢你。家裡是 Android TV/Google TV 的人可以試,但要把它當成會改動系統設定的操作,不是一鍵去廣告。
12GB 顯卡跑得動 763B 的 DeepSeek,但記憶體和硬碟要備足
 圖片:Strata 專案/GitHub,截圖是 README 用 Qwen 模型的示範,不是 DeepSeek
開源本地推論程式 Strata 在 10 月 24 日的 0.2.4 版加進 DeepSeek V4.1-Flash;README 現在已寫到 0.2.6,桌面版和終端機都能選 DeepSeek。這個模型連同 Engram 表約 763B 參數(Unsloth 的說明寫的是 552B 主幹加 196B Engram)。這則 HN 上沒有討論,但對想在自己機器上跑大模型的人,是本週最直接的一則。
Strata 的做法是把專家權重盡量放進顯卡,放不下的交給 CPU 在記憶體裡計算;約 111 GB 的 Engram 表放在 SSD,每生成一個字只讀其中幾列。硬體條件是 NVIDIA RTX 30/40/50(Windows、Linux)或 AMD Radeon AI PRO R9700(Linux),GPU 至少 12GB。專案給的速度是 RTX 3060 12GB 配 46GB 記憶體約每秒 8–11 token,RTX 5070 12GB 配 64GB 約每秒 4–6 token(README 與細節文件的數字略有出入);記憶體低於約 40GB「未測試且很慢」。磁碟依量化等級要 239、257 或 274 GB(1.75/2.00/2.25 bit),建議用 NVMe。
代價在品質。量化來自 ISTA-DASLab,困惑度比原模型高 21%(IQ1_M)、15.5%(IQ2_XXS)、7.3%(IQ2_XS);最小的 IQ1_M 在一般英文文章上差距更大(+53%),程式碼與 agent 任務差距較小(+8.9%、+10.2%)。預設上下文 8,192 token,載入要幾分鐘。以上速度與品質都是專案自己量的,不是我們的實測。手上有 12GB 顯卡、記憶體又在 46GB 以上的人可以試;要拿來日常寫程式,得先能接受每秒 4 到 11 個 token 的速度。
Canva 推出自家圖像模型 Craft,先排好版面再動筆
 圖片:Canva/Introducing Canva Craft
Canva 在 10 月 22 日發表第一個自家圖像模型 Craft。據 TechCrunch,它分兩個階段:先讀提示,規劃元素的位置、相對大小與視覺層次,再生成圖片,最高 2K、支援 30 種長寬比。訓練資料是 Canva 內容庫裡人類做的設計模板,例如海報、社群貼文、簡報和資訊圖表,而不是照片。
所有 Canva 用戶現在都能在 Dream Lab 分頁使用;API 將會開放,Canva 也計畫透過 MCP 讓 ChatGPT、Gemini 等工具調用,並預告更便宜的 Craftfast 與 Craft-ultrafast。我們沒有找到可靠的第三方排名,所以這裡不寫名次。常做社群圖、簡報的人可以直接在 Dream Lab 試;它排版排得好不好,拿自己常做的版面試幾張最清楚。
Google 稱模型不換、agent 自己改流程,分數就多 8 分
 圖片:Google Research/Harness² 專案頁
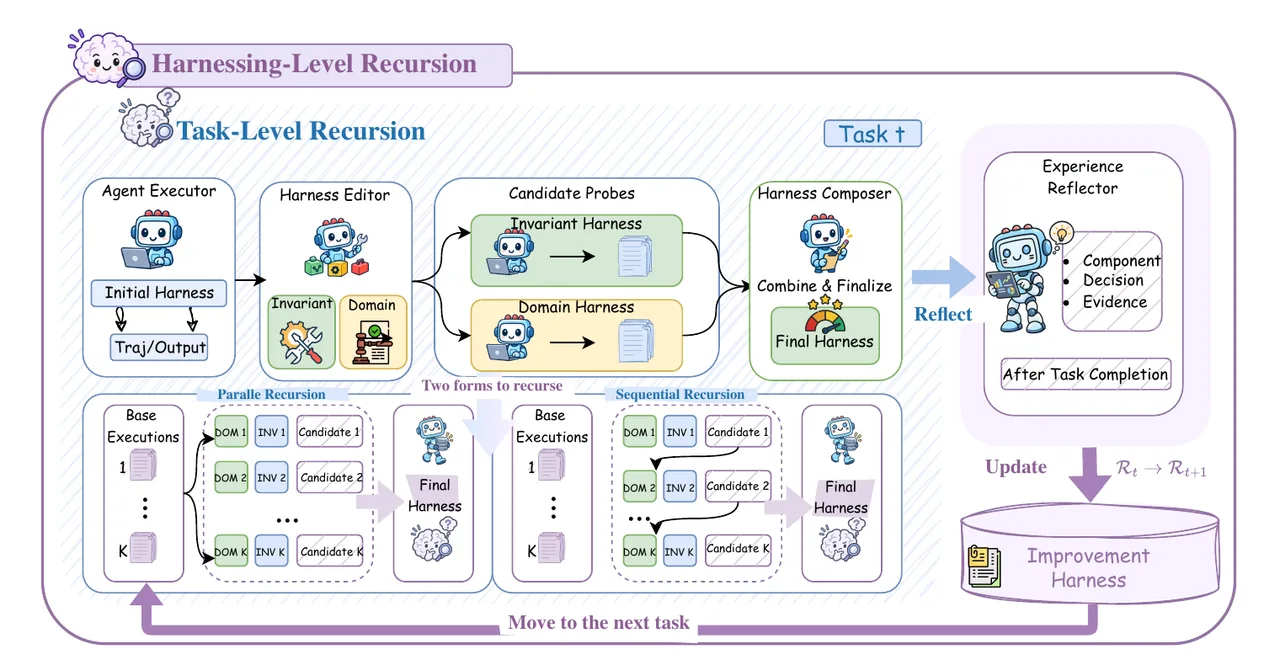
Google Research 發表 Harness²(論文、程式碼)。它把 agent 拆成兩部分:凍結不動的模型,加上可以編輯的 harness,也就是負責給模型資料、呼叫工具、執行動作的那層程式。每做一個任務就改進一次 harness,並把經驗留給後面的任務。HN 上有 81 分、19 則留言。
專案頁主表用的是 Gemini 3.5 Flash 搭配 OpenCode,在 WorkBuddy 基準上取三次平均:起點 72.4,改進一次(k=1)到 77.5,多 5.1 分;平行探索五個候選(k=5)到 80.8,比起點多 8.4 分。對照組 ReasoningBank 是 73.4、Harness Scaling 75.3、Meta-Harness 76.4。這些都是作者自評。對自己在調 agent 流程的人,值得看的是它把「改 harness」當成可以自動化的步驟;分數要等第三方重跑。
騰訊 Hy-Nomas 開源,影片生成到一半能打字改方向
 圖片:騰訊混元/Hy-Nomas 專案頁
騰訊混元開源了 Hy-Nomas,Apache 2.0 授權,權重放在 Hugging Face,也有網頁示範。它是互動式的影片世界模型:影片分段生成,每段之間可以用新的文字提示或相機軌跡改變方向。上面這張只是專案頁的標題卡,沒有生成畫面。
README 的範例是 8 步蒸餾版,240 幀、704×1280、24 fps;在低記憶體設定下(INT8 權重、滑動視窗歷史、CPU 卸載),官方說單張 RTX 4090 可以推論。README 沒有寫 12GB 這類更低的顯存門檻,技術報告還是「Coming Soon」,Hy-Nomas-Bench 是騰訊自建的基準,沒有第三方驗證。有 4090 的人可以照 README 的低記憶體設定試;顯存更小的卡,目前沒有官方說法。
Sakana 稱它的 AI 科學家寫出一篇被學術會議收下的論文
 圖片:Sakana AI/Agentic Scientist 文章
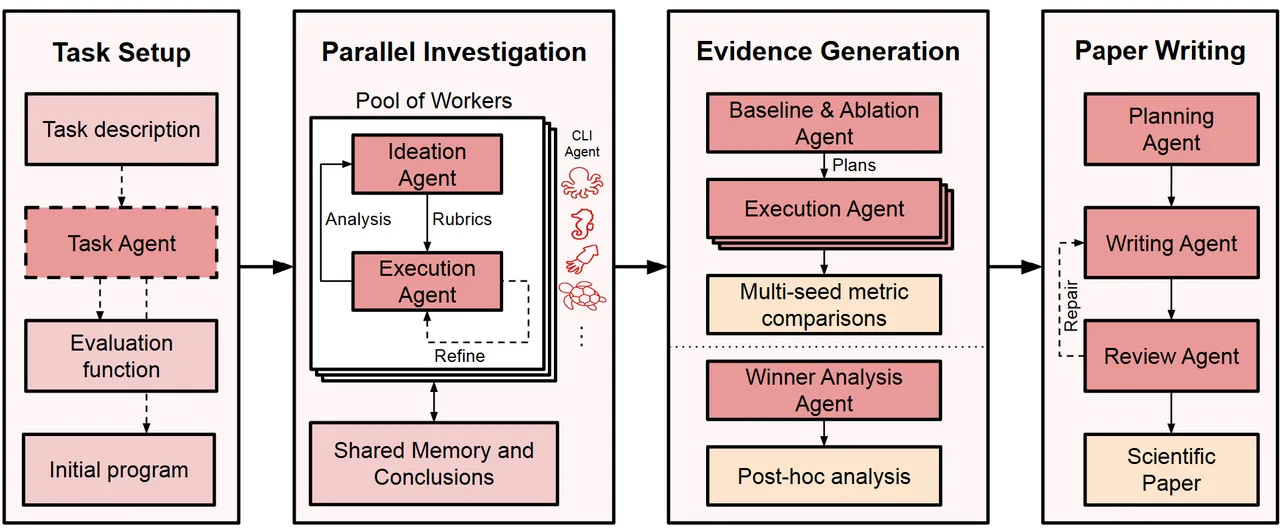
Sakana AI 發表 Agentic Scientist,程式碼庫仍叫 AI-Scientist-v3,Apache-2.0。它不是新模型,而是在 Claude、Codex、Cursor、OpenCode、Gemini、Pi 這些現成 coding agent 外面包一層研究流程,分六個階段:任務草擬、調查、消融實驗、最後評估、事後分析、寫論文。
Sakana 說,它產生的論文裡唯一送外部同儕審查的一篇,被 ALIFE 2026 收為口頭報告。文章也自己列了限制:高分可能來自違反方法本意的捷徑(reward hacking)、比較的基準偏弱、AI 審稿分數只是論文品質的代理,而且所有任務都是在電腦上跑的機器學習實驗。README 另外警告,它會以完整工具權限啟動 coding agent,建議放在 Docker 裡跑。想試的人,第一步就是照它的建議開容器。
還有幾項
Claude 完整平台進駐 Google Cloud,費用併進同一張帳單
 圖片:Anthropic/發表頁
Anthropic 在 10 月 22 日宣布,由 Anthropic 託管的完整 Claude Platform 在 Google Cloud 正式推出:權限走 Google Cloud IAM,用量進同一張 Google Cloud 帳單,也能抵用既有的承諾額度;新功能與測試版跟原生平台同一天提供。目前只有美國與 Global 端點。頁面也建議,要用 Model Armor、Agent Engine 等 Google 原生整合,或有嚴格資料落地要求的客戶,選 Google 託管的選項。
騰訊 4B 視覺模型 WeVisOne-VL,連摳圖都不用另接 SAM
 圖片:騰訊微信視覺團隊/WeVisOne-VL 專案頁
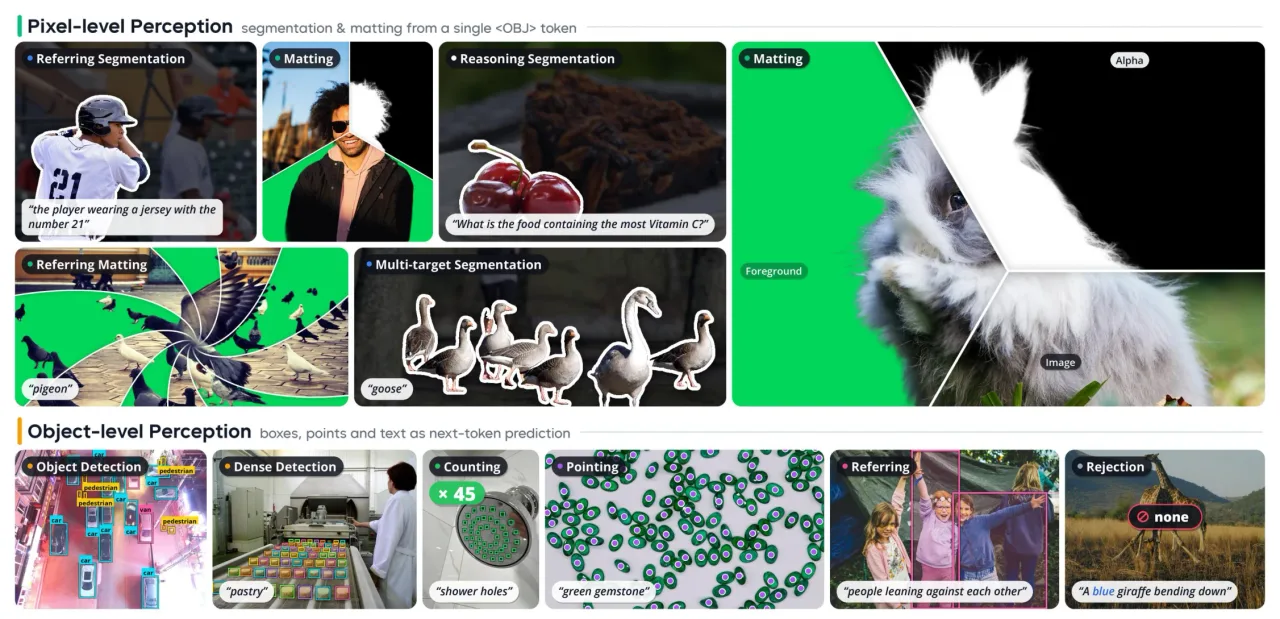
騰訊微信視覺團隊開源 WeVisOne-VL(論文),有 2B 與 4B 兩個大小,Apache-2.0。它能做偵測、指涉、計數、指向與 OCR,另用一個 9.6M 參數的解碼器輸出遮罩與 alpha 摳圖,不需要再接 SAM。
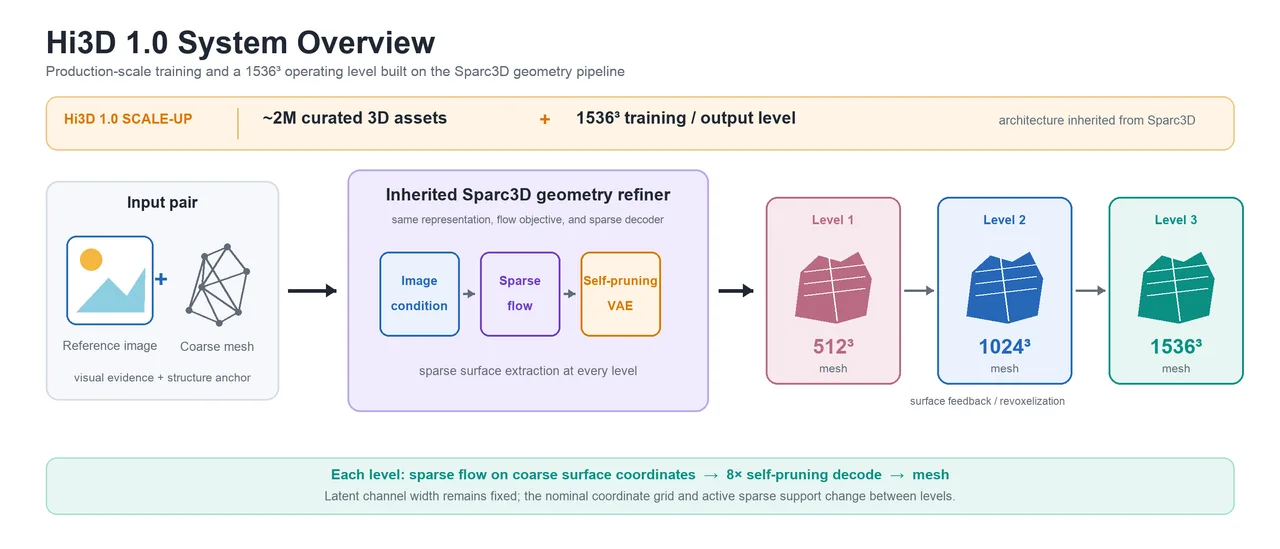
Hi3D V1.0 開放權重,把粗略網格精修成高解析度 3D
 圖片:Hi3D 團隊/Hugging Face 模型頁
Hi3D V1.0 在 10 月 23 日開放權重,建立在 Sparc3D 之上(套件仍沿用 sparc3d 這個名稱)。它從參考圖加上粗略網格,精修出高解析度幾何,輸出 512、1024、1536 立方體素;不生成貼圖。授權是自家的 Hi3D Open License Agreement 1.0,商用前要先讀條款;效能數字是公司自報。
授權與取得方式對照
| 項目 | 實際狀態 | 用之前要注意 |
|---|---|---|
| Kimi K3.1 Pro | App、Kimi Code、API 可用;開放權重尚未釋出 | Moonshot 說權重最晚 11/4 |
| Claude Duet | 研究預覽,美國 Pro/Max 等候名單 | 背景檢查也算用量 |
| Dessa | 等候名單;少數 AI 安全研究者可申請早期存取 | 頁面沒有提開放權重或公開 API |
| Mercury 3 | 只提供 API(Inception、OpenRouter、Baseten、Vercel) | 官方頁沒有說明是否開放權重 |
| cleanyourtv | MIT 開源專案 | 會停用電視套件,先備份 |
| Hy-Nomas | Apache-2.0,權重在 Hugging Face | 官方只說單張 RTX 4090 可推論 |
| WeVisOne-VL | Apache-2.0,2B 與 4B | 授權本身允許商用;權重狀態以專案頁為準 |
| Agentic Scientist | Apache-2.0 | 以完整工具權限啟動 agent,建議用 Docker |
| Hi3D V1.0 | 開放權重,自家 Hi3D Open License 1.0 | 商用前先讀條款 |
| FIBO 2.0(Bria,8B 圖像生成與編輯) | 據 ComfyUI Wiki,CC-BY-NC-4.0 | 非商用;下載前要先同意條款 |
| FastH3 Omni(FastVideo 對 MiniMax H3 的蒸餾) | 據 ComfyUI Wiki,開放權重 | 繼承 MiniMax H3 Community License,部分地區需另行許可;5.6–11.9 倍速度為自報 |
| SKY-001(Skyfall AI 工程設計世界模型) | 據 OrcaRouter,封閉研究預覽、等候名單 | 預計 2027 年初商用;效能為自報 |
另外,Ideogram 在 10 月 22 日的官方貼文發表 Vector 1.0,說可以從文字生成可編輯的 SVG,也能把現有圖片轉成向量,App 與 API 都能用。
11 月 4 日前,先看 Kimi 的權重有沒有放出來
熱度最高的 Kimi K3.1 Pro 還差最後一步:Moonshot 說開放權重最晚 11 月 4 日釋出。那天要看兩件事:權重有沒有準時放出,以及附上什麼授權。這兩件事確定了,它才從「API 上能用的強模型」變成能自己部署的選項。