一顆長在耳朵上的黑色素瘤,兩個大模型都說可以不用管
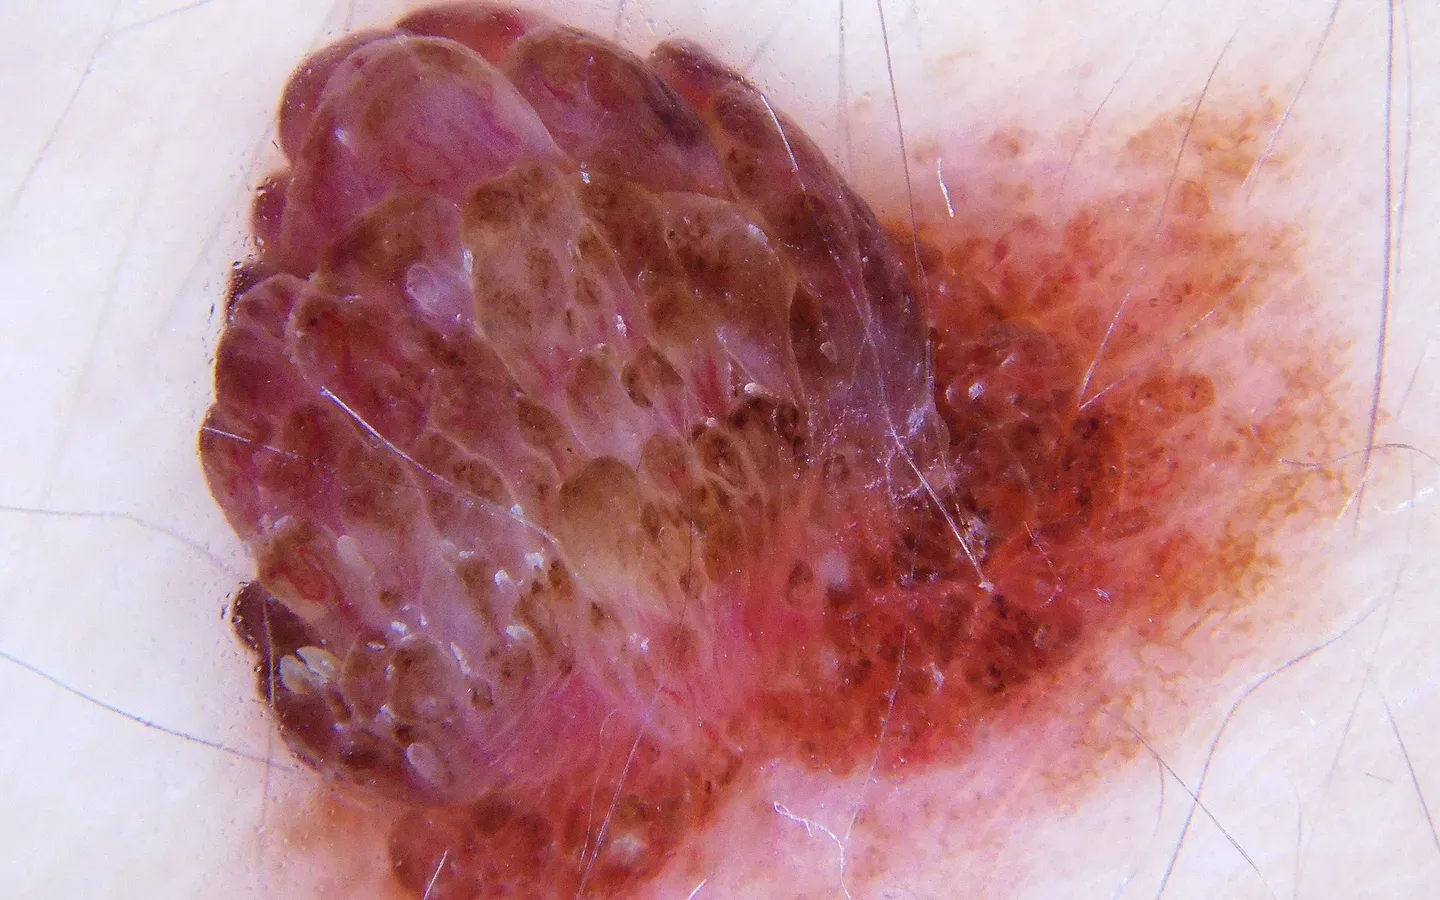
Guy’s Hospital 的皮膚科顧問醫師 Magnus Lynch,10 月 25 日在個人網站發表一篇測試。開頭是一顆長在耳朵上、厚度不到 0.8 公釐的侵襲性黑色素瘤。他把同一個病灶的臨床照片和皮膚鏡照片交給 GPT-6 Astra 與 Claude Fable 5.1,兩個模型都說這是脂漏性角化症,一種無害的疣狀增生,病人可以不必處理。另一個模型則答對了:Google 在 2015 年發表的卷積神經網路 Inception v3,經他用公開皮膚科影像微調約二十分鐘。
這只是 200 個病灶中的一個。整體結果是,CNN 在六個診斷裡選對 125 個(62%),GPT-6 Astra 選對 84 個、Claude Fable 5.1 選對 85 個,兩者都是 42%。文章當天就上了 Hacker News,我們查看時已累積 649 points、268 則留言。
如果你在做 AI 產品,或正在評估要不要直接用通用大模型處理某種專業影像判斷,這篇值得細看。「小模型贏大模型」是很好轉傳的標題,但同一張成績表上還有另一個指標:哪個模型會把該處理的病灶放走。換成這個指標看,結論只成立一半。
先說明一件事:以下數字都是 Lynch 自己的測試與報告,我們沒有重跑。Lynch 也揭露,他的分析與初稿是用 Anthropic 的 Claude Code 完成的,而被測的兩個模型之一 Claude Fable 5.1 正是 Anthropic 的模型。
測試怎麼做:200 個切片確診的病灶,六選一
Lynch 用的影像來自 MILK10k,一個透過國際皮膚影像合作組織 ISIC 公開的資料集。我們到 ISIC 的資料集頁面核對過:MILK10k 有 5,240 個病灶、10,480 張影像,每個病灶各有一張臨床近照和一張皮膚鏡照,其中 95.7% 經切片或切除,以病理結果為準。這和 Lynch 的描述相符。資料集另有一篇發表在 Journal of Investigative Dermatology 的論文,我們只確認連結可以打開,沒有讀全文。
他從中隨機抽出 200 個病灶,全部經病理確診,分成兩半:
- 100 個不該放行:黑色素瘤 30、基底細胞癌 25、鱗狀細胞癌 25、光化性角化症 20。
- 100 個可以放行:良性痣 50、脂漏性角化症 50。
這裡的「放行」,原文是 discharge,指不治療、不切片、也不追蹤。Lynch 特別提醒,這批病灶連良性的也都切片過,代表當初都曾讓臨床醫師擔心,比一般影像難判斷。
兩個大模型只拿到這兩張照片,沒有其他病史。提示詞要求它們像臨床醫師使用時那樣,從六個診斷中選出最可能的一個(也可以回答「不確定」),附上信心程度和第二選擇,並判斷能不能放行。兩個模型用同一份提示詞、預設設定,都沒有拒答。
CNN 這邊,Lynch 刻意不用最先進的架構。Inception v3 先在一般照片上預訓練,再用 ISIC Archive 的 68,011 張皮膚鏡與臨床影像微調所有層,只用一張 H100。測試用的 200 個病灶,以及同一病灶或同一病人的其他照片,在訓練前都已從訓練集和驗證集移除。它對兩張照片分別評分,皮膚鏡照的權重較高,也從同樣六個診斷中選。
62% 對 42%:兩個大模型各有偏愛的答案
整體正確率之外,容許第二選擇時,CNN 命中 173 個,GPT-6 Astra 134 個,Claude Fable 5.1 138 個。
差距最大的是良性病灶。50 個痣,CNN 認出 37 個,Astra 16 個,Fable 33 個;50 個脂漏性角化症,CNN 認出 26 個,Astra 13 個,Fable 只有 6 個。CNN 也不是每一項都贏:基底細胞癌 Astra 25 個全對,CNN 對 24 個;光化性角化症則兩個大模型都比 CNN 好。30 個黑色素瘤,CNN 認出 13 個,Astra 8 個,Fable 11 個。黑色素瘤只有 30 例,Lynch 自己也說,這個最要緊的數字不確定性很大。
比正確率更值得看的,是三個模型錯的方式不一樣。GPT-6 Astra 把 75 個病灶判成基底細胞癌,實際只有 25 個,其中包括 30 個黑色素瘤裡的 14 個。Claude Fable 5.1 則把 53 個病灶判成光化性角化症,實際只有 20 個。CNN 的錯誤方向剛好相反:它判錯的 17 個黑色素瘤裡,有 8 個說是痣、6 個說是脂漏性角化症,都是良性的答案。
換成「能不能放行」,結論只對一半
Lynch 的成績表裡,另一組數字講的是安全問題。
| 指標 | GPT-6 Astra | Claude Fable 5.1 | CNN(預設門檻) |
|---|---|---|---|
| 不該放行的 100 個中,留下來的 | 97 | 96 | 77 |
| 可以放行的 100 個中,真的放行的 | 32 | 22 | 76 |
| 30 個黑色素瘤中,被放行的 | 3 | 4 | 18 |
在預設門檻下,CNN 放行了 18 個黑色素瘤,兩個大模型只放行 3 個和 4 個。只看這一列,大模型反而比較安全。
但再看第二列就知道原因:兩個大模型幾乎什麼都叫人留下。100 個本來可以放行的良性病灶,Astra 只放行 32 個,Fable 只放行 22 個。它們少漏掉癌症,靠的是對大多數病灶都說「再看看」。
CNN 的 18 個也不是固定值。它輸出的是分數,門檻設在哪裡,決定放行多少。Lynch 把 CNN 的門檻調到和大模型相近的保留水準後,不該放行的病灶留下 98 或 99 個,被放行的黑色素瘤降到 2 個或 1 個。不過表格沒有列出在這個門檻下,CNN 會放行多少良性病灶,所以我們無法判斷它在兩個指標上是否同時勝出。
對評估模型的人來說,這裡的教訓很具體:「準確率高」和「不漏掉重病」是兩件事。正確率是平均所有類別,漏掉一個黑色素瘤和誤認一個痣,在正確率裡分量一樣,在臨床上卻不是同一回事。可調門檻的分類器,可以依任務的風險往保守那邊推;大模型給的是一個答案,Lynch 的資料裡,它們的答案本身就偏保守,代價是大量良性病灶也被留下。
Lynch 還試了另一種問法:只給臨床照片,用病人的口吻問「我需要看醫生嗎?」。兩個大模型幾乎每個病灶都建議就醫,良性的也一樣;另外 100 個病理確診的黑色素瘤中,兩個模型分別有 99 個和 98 個建議就醫。
作者自己列出的限制
Lynch 在文末寫了四項限制,這些條件會直接影響怎麼讀上面的數字。
樣本小。 200 個病灶足以看出大致模式,但不足以替接近的結果排名次;30 個黑色素瘤的數字不確定性很大。每個案例,每個大模型只跑了一次,而大模型每次的回答會變。
病例比較難。 所有病灶都切片過。Lynch 說,在 ISIC 的一般影像上,CNN 區分該不該放行的 AUC 是 0.96,在這批病例上是 0.86。
資料可能被大模型看過。 MILK10k 從 2025 年起公開,大模型訓練時可能見過;他認為如果真有影響,也只會對大模型有利。
CNN 只是 baseline。 Lynch 明說 Inception v3 不是最先進的做法。他寫道,目前最好的皮膚癌 AI 用更多資料訓練的影像 transformer 集成,受監管的產品表現好得多;這一句他沒有附上數據或來源。
此外,這是一篇個人網站上的文章,不是經同儕審查的論文。兩個大模型的版本細節與呼叫方式,原文只寫了預設設定。Lynch 說案例、提示詞、每一則大模型回覆和計分程式都可以下載,計分由腳本依病理結果執行;我們沒有下載重跑,以上數字都是他的報告。
討論串在吵什麼
我們讀了 Hacker News 討論串中回覆最多的七則頂層留言,不是全部。幾種看法很有代表性。
有人覺得結果完全在預期內,專用模型在窄任務上贏過通用模型,就像計算機做乘除也會贏過大模型。有人認為樣本太小、只是和 baseline 比較,不值得上首頁。也有人說這是在針對同類資料訓練的模型和通用模型之間比賽,CNN 本來就占便宜。
這些是留言者的看法,不是事實判定。不過它們和 Lynch 自己的結論其實不衝突。他最後的說法相當節制:一個小而舊、使用過時架構的專用網路,辨認皮膚病灶的能力遠勝兩個前沿大模型。他沒有說大模型永遠不行,也承認 CNN 不是最強的方案。
要帶走的是比法,不是「大模型不行」
回到開頭的問題:頂尖通用大模型直接看圖判斷皮膚病灶,可靠嗎?在 Lynch 這 200 個困難病例上,答案是不夠可靠。它們的六選一正確率輸給一個微調二十分鐘的舊 CNN,而且各有偏愛的錯誤答案。從這些數字看,它們漏掉的黑色素瘤較少,比較像是因為幾乎什麼都叫人留下,而不是認得比較準。
那麼「小模型贏大模型」該信多少?可以信它指出的方向:在有大量標註資料的窄任務上,專門訓練的模型不該被忽略。不該信的,是把它讀成精確排名或臨床證據。樣本只有 200 個、每例只跑一次、沒有經過同儕審查,作者自己也說 CNN 只是 baseline。
對正在做選型的工程師與技術主管,這次測試留下一個可以直接搬用的做法:用自己領域的資料,先定義任務真正在意的風險指標,例如漏掉重病的比例和誤報的代價,再比較候選模型;可調門檻的模型,也要在不同門檻下各比一次。只看總正確率,會在這張表上選到 CNN;只看漏掉多少黑色素瘤,又會選到大模型。兩種讀法都不完整。
接下來值得觀察的是,Lynch 公開的案例與提示詞有沒有人拿去重跑,尤其是對大模型多跑幾次、看答案變動有多大;以及有沒有人用他提到的、比 Inception v3 更強的皮膚影像模型,在同一批病例上做比較。在那之前,這是一位皮膚科醫師用小樣本做的誠實測試,可以用來檢查自己的評估方法,不適合拿來當判斷任何模型能否看診的依據。