在 Tianyu Chen 公開的一局 Pokémon 對戰記錄裡,第 12 回合得決定繼續攻擊、回血,還是換人。Jev 選擇換上 Scizor(巨鉗螳螂),周邊程式接著執行。模型沒有寫攻略,卻能把一個選擇交回程式,讓遊戲繼續走。
TypeSafe AI 在 9 月 15 日推出的 Jev,就是針對這類工作做的模型。你提供當前資料、問題和允許的答案,它直接回傳選項或數值,沒有自由文字回覆。官方把這種做法稱為 System One model:讓軟體裡頻繁出現的小判斷,可以用更簡單的介面完成。
客服分流也有類似的小判斷:交給哪個部門、今天要不要處理、先排哪件事。Jev 的用處,是在程式已經準備好資料和選項時,直接回答這些問題。社群已經有人把它接進遊戲與場景控制;用到工作裡,速度和可靠性仍要另外驗。
用一封客訴看懂 Jev 在回答什麼
以一封假設客訴為例:「信用卡被扣了兩次款,訂單頁卻只有一筆,今天能幫我處理嗎?」
程式可以先查訂單,把顧客訊息、扣款紀錄和公司的處理規則整理成一份 state。這個詞指的就是模型這次判斷能看到的資料。接著,用 Jev 的三種問題型別提問:
| 這次要判斷什麼 | 用哪一種問題 | 回來的答案怎麼用 |
|---|---|---|
| 案件該交給哪個部門? | Choice:選部門,附各選項機率。 | 送進對應佇列。 |
| 問題有多嚴重? | Score:依有序等級評分。 | 排序或決定優先程度。 |
| 按規則,今天要處理嗎? | Noul:回傳「是」的機率。 | 依已驗的門檻處理或覆核。 |
Choice 的選項由你準備,最多可有 255 個;如果案件可能落在清單外,就加上「其他」或「以上皆非」。漏掉合理答案,模型也只能在不完整的清單裡選。Score 則需要 2 到 10 個有順序的等級,並說清楚每一級代表什麼;回傳的分數可以落在兩個等級之間。只有「低、中、高」三個字,卻沒有判準,團隊自己可能也會分得不一致。
Noul 的數值介於 0 和 1,表示答案為「是」的機率。
同一份 state 可以一次問多題。官方說這些問題會獨立、並行判斷,因此選部門、評嚴重度和判急迫性,可以一起送出。不過,「獨立」也代表前一題的答案不會自動成為後一題的資料。
假如選出帳務部後,程式還得去查另一套帳務規則,第二個問題就要等資料查回來再問。這一段先後關係由程式安排,不能把同一次請求想成模型已經跑完多步工作。
LLM、Jev 和程式,各自接哪一段
回到這封客訴,程式負責查訂單、核對金額、執行分流,也負責哪些人有權退款。Jev 可以判斷訊息在說什麼、案件該往哪裡走。需要把處理結果寫成顧客看得懂的回覆時,再交給 LLM。
實際接入時,還要有一層程式把資料、問題、工具和下一步串起來,通常稱為 harness。它決定模型看得到什麼、有哪些選項、答案怎麼組合,以及失敗時誰接手。模型再快,harness 查錯訂單或漏掉政策,整件事仍會做錯。
Reddit 使用者 PerceptionCharming 分享的 Grassworks 場景控制實驗,把這層分工做得很直觀。作者說,他將 Three.js 草地場景的 50 多個控制參數及說明交給 Jev,讓人用下雨、黃昏或秋天等口語需求設定場景。Jev 在既定值與範圍裡做選擇,再由程式調整草地、天空、雲和燈光。
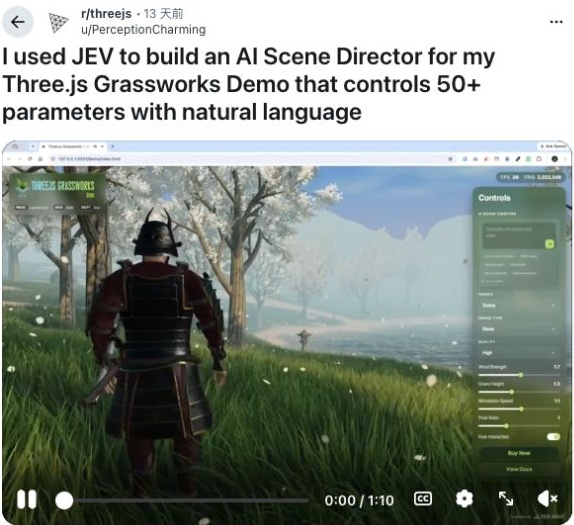
畫面是既有 Three.js 程式畫出來的,Jev 負責選控制值,沒有重寫整個場景或生成新影片。留言有人問,風速、日夜本來就能拉滑桿,何必加 AI?作者的回答是,秋天會一起牽動天空、燈光、草色和草的行為,一句話可以協調多個參數。這個例子要試的,是口語設定能不能省下逐個調整的工作;精確改一個值時,滑桿仍然方便。
這是作者自述的實驗。他也說,當時公開的 Grassworks demo 尚未包含 Jev 整合,因此不能把公開 demo 的畫面當成 Jev 指令的結果。
Jev 目前只接受文字資料,包括字串、JSON 或文字陣列。螢幕、圖片和影片得先由 OCR、視覺模型或其他工具轉成文字;示範裡能操作畫面,不代表 Jev 本身能直接看圖。官方也說它主要以英文訓練,能處理中日韓文字,但品質不均。要用在台灣客服,繁體中文、口語、錯字和中英混寫都得放進測試,不能直接照搬英文結果。模型文件列出了這些輸入與語言條件。
至於模型內部,TypeSafe 說它使用新的架構、並行採樣器,以及名為 RLCD(Reinforcement Learning for Calibrated Decisions)的訓練方法,目標是讓決策機率更貼近實際結果。模型大小、權重和完整訓練細節仍未公開。現在能清楚理解的是它提供的介面與使用方式,還不足以從這些說明斷定內部怎麼實作,更不能把所有類似決策模型都當成同一種架構。
便宜、快,得連同工作流程一起看
截至 10 月 5 日,Jev 公布的價格是每百萬輸入 tokens 0.042 美元,輸出免費。也就是說,模型費用按送進去的文字量計算;state 和各個問題都要算,不能把這個價格讀成每次呼叫的固定費用。
這個價格對頻繁的小判斷很有吸引力。即使如此,查資料、整理 state、重試、覆核和維護程式仍會花時間與錢。要比較新舊方案,最好用同一批案件走完整段流程,才能知道省下的費用有沒有被別處的工作吃掉。
速度也是如此。官方公布端到端回應時間約 70 到 500 毫秒,並用特定工作流程得出快約 193.6 倍、便宜約 444.6 倍的比較。這些測試使用美西的服務與筆電客戶端,短而資訊密集的 state 對 Jev 更有利;官方也承認這些數字可能接近真實收益的高端。比較中的參考答案來自大型模型的機率平均,不能當作人工核對的正確率。公告的測試說明保留了這些條件。
如果你的流程大多在等資料庫、外部 API 或人工批准,換掉其中一個模型,整件事未必會快上百倍。比較有機會先看到差異的,是資料已經備好、要連續做很多語意分類或排序的小任務。
Pokémon 的第 12 回合,機率怎麼變成動作
看開頭那局對戰的原始記錄,場上的 Slowbro(呆殼獸)正面對 Gastrodon(海兔獸)。harness 先估算傷害、整理最近幾回合的紀錄,再列出四個候選:換上 Scizor、用 Psychic、用 Ice Beam,或用 Slack Off 回血。它也提醒模型,換人可能白吃對手一擊;留場繼續打,自己又可能先倒下。
這些狀態與合法選項交給 Jev 後,問題是選哪個單一動作比較可能贏整場。Jev 回傳的四項機率是 0.72、0.24、0.02、0.02,首選是換上 Scizor。程式採用這個選項,存檔裡下一個事件就顯示 Scizor 上場。
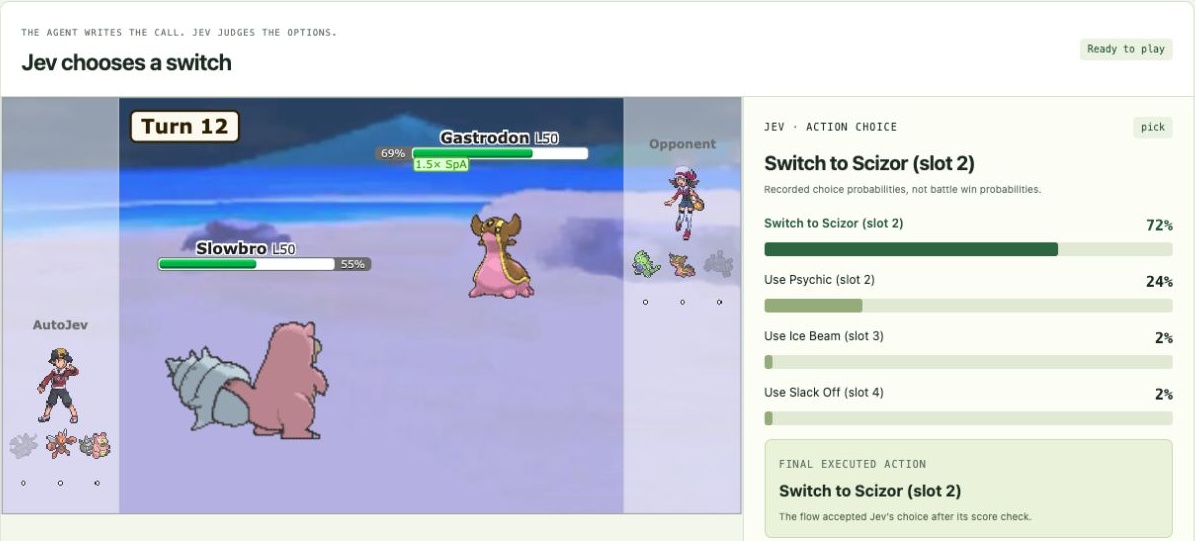
0.72 是這四個候選裡「換上 Scizor」的選擇機率,不能讀成換人後有 72% 勝率。這局最後在第 15 回合獲勝,也不能證明勝利由這一次換人造成。傷害估計仍有未知的道具、能力與招式,模型沒有看穿對手。
這個案例能看清楚三段工作:harness 準備狀態和候選,Jev 選一個動作,程式執行。LLM 可以先協助寫策略、程式與提問,再讓 Jev 在執行時做小判斷。專案作者報告,修改 harness 後,評估勝場從 12 場中的 3 場增加到 9 場;沒有訓練 Jev 的權重,而且這批評估參與了版本挑選,不能當作另一批未參與調整的結果。
「零幻覺」保證了格式,判斷仍可能錯
Jev 的「0% hallucination」很容易讓人以為可以放心交給它決定。官方在公告裡給的定義,是答案符合指定的 schema:你只允許帳務、物流、技術支援和其他,它就不會憑空多回一個不存在的部門。
這能省掉解析文字和檢查輸出格式的麻煩。但如果它把重複扣款判成物流問題,答案仍然合法,案件仍然送錯。格式保證和判斷正確,要分開驗。
回傳的機率,也值得多看一眼。模型說某個答案的機率是 0.9,若它在你的任務上校準得好,那麼很多相似、都被給到這個機率的判斷,整體大約應該有九成符合結果。這是對一群判斷的檢查,無法保證眼前這一筆一定對。
Choice 和 Score 還會回傳一個 confidence。它是依機率分布算出的摘要,會受問題型別與選項設定影響;例如 Choice 會看最大機率相對於平均分配有多集中。因此 confidence = 0.9 不能直接讀成「這次有九成把握答對」。Noul 只有答案為「是」的機率,沒有另一個獨立的 confidence。官方的 confidence 說明區分了這些數值。
Lingsen Meng 的校準審查把這個問題測得更具體:同一批 872 段英文影評、同一個 Jev 版本,一次用 Noul 問「這段影評是正面的嗎?」,另一次用 Choice 給「正面/負面」兩個候選。作者測得兩種問法的 ECE 分別是 0.091 和 0.020。ECE 衡量回傳機率與觀察結果的落差,越低表示在這批資料上越接近。
這兩次測試的文字沒有換,問法卻改變了機率的校準表現。所以即使任務都叫影評分類,也不能把一種問法驗好的自動處理門檻直接搬到另一種。這份審查只涵蓋兩類英文任務,不能替所有 Jev 用途下結論;用繁體中文客服資料時,仍得看自己的錯誤與機率分布。
另外,JevAdvBench 預印本測的是輸入被加入不同內容後,決策會不會改變;作者發現,未經核實的意見可能讓答案翻轉。這不等於每次翻轉都是答錯,卻說明合法格式仍然可能受到輸入內容影響。顧客訊息、外部網頁裡的指令和公司的可信規則,harness 得分清楚。
先拿一個分流問題來試
如果要開始用 Jev,我會先挑「案件該進哪個佇列」這種結果容易核對、送錯也能追回的工作。把選項和規則寫清楚,保留其他類別,再找一批有人工答案的案件,跟原本的規則程式或 LLM 做法比較。
看平均正確率之外,也要看重複扣款這類重要案件漏了多少、哪些機率區間常出錯,以及人工覆核有沒有變多。用另一批沒參與調整的案件檢查門檻,資料不足或含糊的案子交給客服。這時再量整段延遲和成本,才知道 Jev 在這個流程裡有沒有幫上忙。
調門檻時可以固定模型版本,因為官方的模型別名可能隨更新移動;10 月 5 日文件所列的版本是 jev-1.13.0。如果換了模型、問題或部門清單,再重驗一次。
對這個客服流程,第一版先做到案件分流,並保留客服接手的路徑。分流是否正確、覆核花多久、整段處理有沒有變快,都能查到結果;有了這些證據,再決定要不要接上退款或自動回覆。